マルチモーダルAIとは?仕組みと最新活用事例を徹底解説【2026年最新】
テキストを入力して文章を返してもらうだけの時代は、完全に過去のものとなりました。現在の生成AIは、文字だけでなく画像、音声、動画、センサーデータまでを同時に処理し、まるで人間のように「見て、聴いて、話す」能力を獲得しています。これこそが、産業界のデジタル構造を塗り替えつつあるマルチモーダルAI(Multimodal AI)です。
「ChatGPTに画像を見せたら的確なアドバイスが返ってきた」「会議の音声をリアルタイムで図解してくれた」といった日常的な体験の背後では、基盤モデルのアーキテクチャに決定的なパラダイムシフトが起きています。単一の情報しか扱えなかった従来のAIと何が違うのか、なぜ今あらゆるビジネスで導入が急務とされているのか、その仕組みと現場の最前線を徹底解明します。
📌 【この記事の重要ポイントまとめ】
- 要点1:マルチモーダルAIとは、テキスト・画像・音声・動画など複数のモダリティ(情報形態)を統合して同時に処理・推論する次世代AI技術である。
- 要点2:従来の「テキスト専用AI(シングルモーダル)」と異なり、視覚と聴覚の文脈をクロスオーバーさせて理解するため、医療画像診断や自動運転、現場業務の自動化で劇的な精度向上を実現している。
- 要点3:GPT-4oやGeminiをはじめとする主要モデルの進化により低遅延・低コスト化が進む一方、計算リソースの肥大化やハルシネーションの複合化といった運用課題への対策が成否を分ける。
【仕組みをわかりやすく解説】マルチモーダルとシングルモーダルの決定的な違い
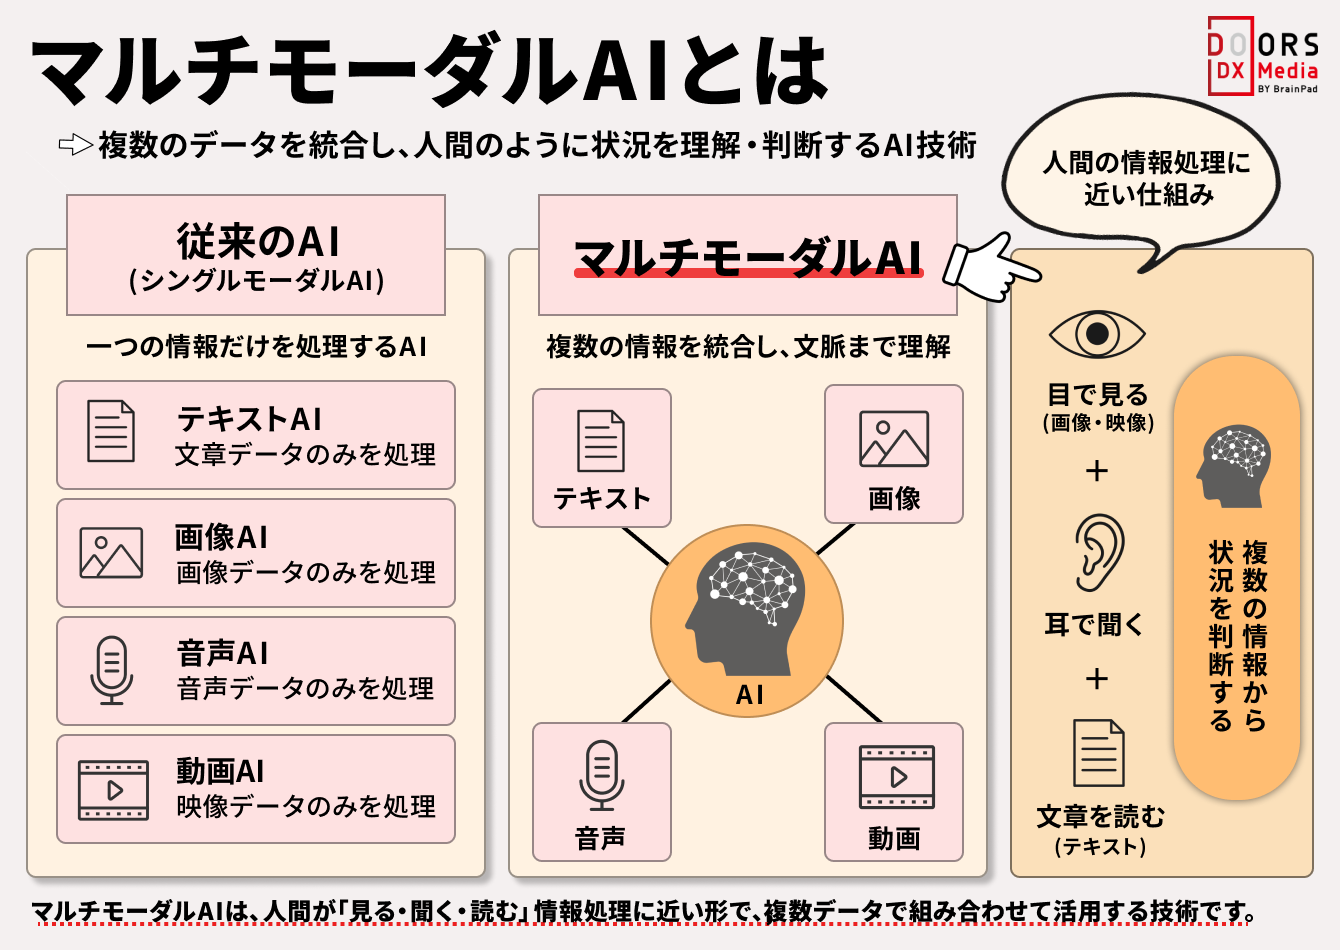
マルチモーダルAIの基礎を理解する鍵は、「モダリティ(Modality=情報の種類・様式)」の統合にあります。私たちが日常会話をするとき、相手の言葉(テキスト・言語)だけでなく、表情(視覚情報)や声のトーン(音声情報)、身振り手振りを総合して意図を汲み取っているのと同じ構造です。
従来のAIは、テキストなら自然言語処理、画像なら画像認識、音声なら音声認識と、領域ごとにモデルが完全に独立した「シングルモーダルAI」でした。たとえば、動画から音声を抜き出して文字起こしをし、そのテキストを別のAIに要約させ、さらに画像解析AIでフレームを調べるというように、複数のツールを無理やり連結(パイプライン処理)していたため、処理の遅延や文脈の欠落が避けられませんでした。
これに対し、近年のマルチモーダル大規模言語モデル(MLLM)は、最初から画像・音声・テキストを同一のベクトル空間(エンベディング空間)で同時に学習しています。画像認識と音声認識が別々の機能として存在するのではなく、1つの巨大な脳の中で「見ている映像のこの部分について、この声のニュアンスで質問された」という複合的な文脈をミリ秒単位で直接解釈できる点が、従来の生成AIとの決定的な違いです。
【徹底比較】主要マルチモーダルモデルの実力と現場スペック
現在、業界をリードする代表的なモデル群は、それぞれ異なる強みを持って設計されています。公式発表資料や開発者コミュニティのベンチマーク検証データをもとに、現場導入で重要視される性能差を整理しました。
| 項目・モデル名 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| GPT-4o(OpenAI) | 音声応答遅延平均232ミリ秒(人間と同等水準)、テキスト・音声・ビジョン完全統合 | 従来のパイプライン型音声対話は2〜5秒の遅延が発生 | リアルタイム通話や対面接客アシスタントにおいて圧倒的な会話の自然さを誇る。 |
| Gemini 1.5 Pro / Ultra(Google) | コンテキストウィンドウ最大200万トークン(動画約2時間、音声約22時間の一括処理) | 標準的なLLMは3.2万〜12.8万トークン程度が主流 | 長尺動画や膨大なマニュアルPDFの一括照合において他を寄せ付けない情報処理力。 |
| Claude 3.5 Sonnet(Anthropic) | ビジョン推論ベンチマークで高スコア、チャート・図表・手書きUIからのコード生成精度が高い | 一般的な視覚認識は単純な物体検知が中心 | エンジニアリングやUI/UX設計、複雑な学術論文の図解解析で実務適性が極めて高い。 |
【実態検証】ビジネスと社会を変える最新活用事例の現場
研究開発の段階を終え、実社会での実装が加速度的に進んでいます。特に顕著な成果を上げているのが、医療、モビリティ、そして製造現場です。
1. 医療応用:CT・MRI画像と電子カルテの統合解析
医療分野におけるマルチモーダル医療応用事例は、診断の正確性を劇的に引き上げています。放射線科の画像データだけでなく、患者の既往歴、血液検査の数値データ、診察時の会話記録を単一のモデルで照合。報道各社や学会発表のデータによると、微小ながん病変の見落とし率を従来比で約30〜40%削減させる臨床支援システムが実用化フェーズに入っています。
2. 自動運転:カメラ映像とセンサー・音声情報の協調制御
モビリティ領域のマルチモーダル自動運転技術では、LiDARの点群データ、車載カメラのリアルタイム高解像度映像、さらには救急車のサイレン音といった音響データをミリ秒単位で融合。急な歩行者の飛び出しや悪天候下での白線認識など、単一センサーでは対応しきれなかった「エッジケース(例外事象)」への即応性が飛躍的に向上しました。
3. 製造・インフラ点検:現場作業員の「目と耳」を代替
大手プラントや鉄道会社では、スマートグラスを装着した作業員の見ている映像と稼働音をAIが常時監視。異音の発生箇所を視覚的にハイライトし、過去の保守マニュアルの該当ページを即座に網膜ディスプレイへ投影するシステムが稼働しています。熟練技術者の退職に伴う技術承継の課題を、AIが直接補完する構図が生まれています。

一般に知られていない盲点とネットの誤解|メリット・デメリットの真実
ソーシャルメディア等では「マルチモーダルAIさえあれば人間は何も不要になる」といった極端な言説も見受けられますが、実際の運用には見過ごせないトレードオフが存在します。マルチモーダルAIのメリットとデメリットを冷静に切り分ける必要があります。
最大のメリットは、情報のインプット作業における「構造化の手間」が消滅したことです。紙の請求書のスキャン画像、手書きのメモ、音声通話の録音をそのまま放り込むだけでAIが意図を理解するため、データ前処理のコストが劇的に削減されました。
しかし一方で、「マルチモーダル・ハルシネーション(複合的幻覚)」という深刻なデメリットが存在します。テキスト単体では正確だったモデルが、不鮮明な画像やノイズ混じりの音声を入力された途端、画像内の無関係な影を「重要情報」と誤認し、もっともらしい嘘を出力してしまう現象です。さらに、画像や音声のトークン消費量はテキストの数倍から数十倍に跳ね上がるため、API利用コストやオンプレミスサーバーの消費電力が予算を圧迫するケースが多発しています。
【プロの結論】導入すべき組織・慎重になるべき現場の明確な判断基準
組織論およびテクノロジー導入の観点から見ると、マルチモーダルAIへの投資効果は「現場で扱うデータの非構造化率」によって完全に二極化します。
積極的に導入・開発を進めるべきケース
- 現場に紙伝票・手書き図面・現地写真が溢れている業務:不動産査定、建設現場の進捗管理、保険の損害査定など、視覚情報が業務判断の核となる領域。
- リアルタイムの対話・感情把握が価値を生む現場:コンタクトセンターのクレーム対応、オンライン教育、多言語同時通訳。
現時点では慎重に様子を見るべきケース
- 数値データや定型テキストのみで完結している業務:財務会計の仕訳や定型の法務契約レビューなど。これらは従来のシングルモーダルLLMや専用のRPAの方が、はるかに低コストかつ高精度で運用可能です。
- 1ミリの誤りも許されない完全無人オペレーション:ハルシネーションの完全排除が保証できない以上、人間の最終確認(Human-in-the-Loop)フローが組めない現場への丸投げは致命的なリスクを伴います。

【2026年以降の展望】マルチモーダルAIの今後の課題と将来性
今後の技術競争は、画面の中にとどまらず、現実世界の物理空間で動く「フィジカルAI(Physical AI)」やロボティクスとの完全融合へとシフトしています。
人型ロボット(ヒューマノイド)が視覚で作業対象を捉え、触覚センサーのフィードバックを感じながら繊細な力加減を調整し、人間の音声指示に従って柔軟に動く技術の実証実験がすでに国内外で進められています。著作権保護の法整備や、悪意あるディープフェイク動画・音声の悪用防止といった倫理的・法的な課題への対処が国際標準化機構等で急務とされる一方、産業競争力のコアとしてその進化のスピードが鈍ることはありません。
【マルチモーダルとは】に関するよくある質問(FAQ)
Q1:マルチモーダルAIとこれまでの生成AI(ChatGPTなど)の一番の違いは何ですか?
A1:これまでの初期生成AIは主に「テキスト(文字)」のみをやり取りするシングルモーダルでしたが、マルチモーダルAIはテキスト・画像・音声・動画など異なる種類のデータを1つの脳で同時に理解し、出力できる点が決定的な違いです。
Q2:個人でもマルチモーダルAIを無料で体験することはできますか?
A2:はい、可能です。ChatGPT(GPT-4o)やGoogle Geminiの無料版アプリを利用すれば、スマートフォンのカメラで撮影した写真を送って質問したり、音声でリアルタイムに対話したりするマルチモーダル機能を即座に体感できます。
Q3:企業がマルチモーダルAIを導入する際の最大の注意点は何ですか?
A3:テキストに比べてデータ通信量およびAPI利用料が大幅に高額化しやすい点と、視覚情報に対する誤認識(画像ハルシネーション)のリスクです。すべての業務を一括で置き換えるのではなく、実証実験(PoC)を通じて費用対効果を厳密に検証することが推奨されます。
まとめ:五感を手に入れたAI時代を勝ち抜くための意思決定
マルチモーダルAIの本質は、単なる機能の追加ではなく、「人間が暮らす非構造化された現実世界」をAIがそのまま認識できるようになったことにあります。文字入力というインターフェースの制約から解き放たれたことで、デスクワークのみならず、あらゆる産業の現場業務が変革の射程に入りました。
重要なのは、その全能感に惑わされることなく、自社のどの業務ボトルネックが「視覚」や「聴覚」の統合によって解消されるのかを冷静に見極めることです。技術の仕組みと限界を正しく把握した組織だけが、この巨大な変革の波を確かな競争優位性へと変えることができます。 (出典: マルチ モーダル と は(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。