名義尺度とは?4つの尺度水準の違いと分析で失敗しない基本知識
アンケート集計やマーケティングリサーチの現場で、数字として入力されたデータをそのまま平均してしまい、意味のない数値を導き出してしまうトラブルは後を絶ちません。その原因の多くは、データの根本的な性質である「尺度水準」の混同にあります。
データ分析の出発点となるのが名義尺度(Nominal Scale)です。数理的な意味を持たない分類番号を正しく扱えるかどうかは、集計結果の信頼性を左右する決定的な分岐点となります。心理学者スティーヴンスが提唱した体系に基づき、実務で絶対に押さえておくべきポイントを整理しました。
📌 【この記事の重要ポイントまとめ】
- 要点1:名義尺度は「単なる区別・分類のためのラベル」であり、大小関係や四則演算の概念が存在しない質的データである。
- 要点2:数値が割り振られていても平均値や中央値の算出は無意味であり、代表値には「最頻値」、分析には「クロス集計」や「カイ二乗検定」を用いる。
- 要点3:順序尺度・間隔尺度・比率尺度との境界線を誤ると分析ロジック全体が破綻するため、ダミー変数化などの適切な前処理が必須となる。
【基礎知識】名義尺度とは?分類とラベル付けに特化したデータの特徴
データ分析の基礎知識において、収集した情報はまず質的データと量的データの分類から始まります。このうち質的データに属し、もっともシンプルな構造を持つのが名義尺度です。
1946年にアメリカの心理学者S.S.スティーヴンス(Stanley Smith Stevens)が提唱した「尺度水準」の理論において、データは性質に応じて4段階に体系化されました。名義尺度はその第1段階に位置づけられ、対象を区別・分類するためだけに割り当てられた名称や番号を指します。
名義尺度の代表的な具体例には以下のようなものがあります。
- 性別・血液型:「男性=1、女性=2」「A型=1、B型=2、O型=3、AB型=4」など
- 地理情報・属性:都道府県コード、居住地域、所属部署
- 商品カテゴリー:「家電=101、食品=102、衣類=103」などの商品ID
- アンケートの単一回答:「支持政党」「利用した交通手段」「はい=1、いいえ=0」
ここで重要なのは、便宜上割り振られた数字(1や2)に数量的な意味が一切ないという点です。「女性(2)は男性(1)の2倍である」という解釈や、「食品(102)は家電(101)より大きい」という順序付けは成立しません。あくまで名前の代用(ラベル)として数値を割り振っているに過ぎない点が、名義尺度の本質です。
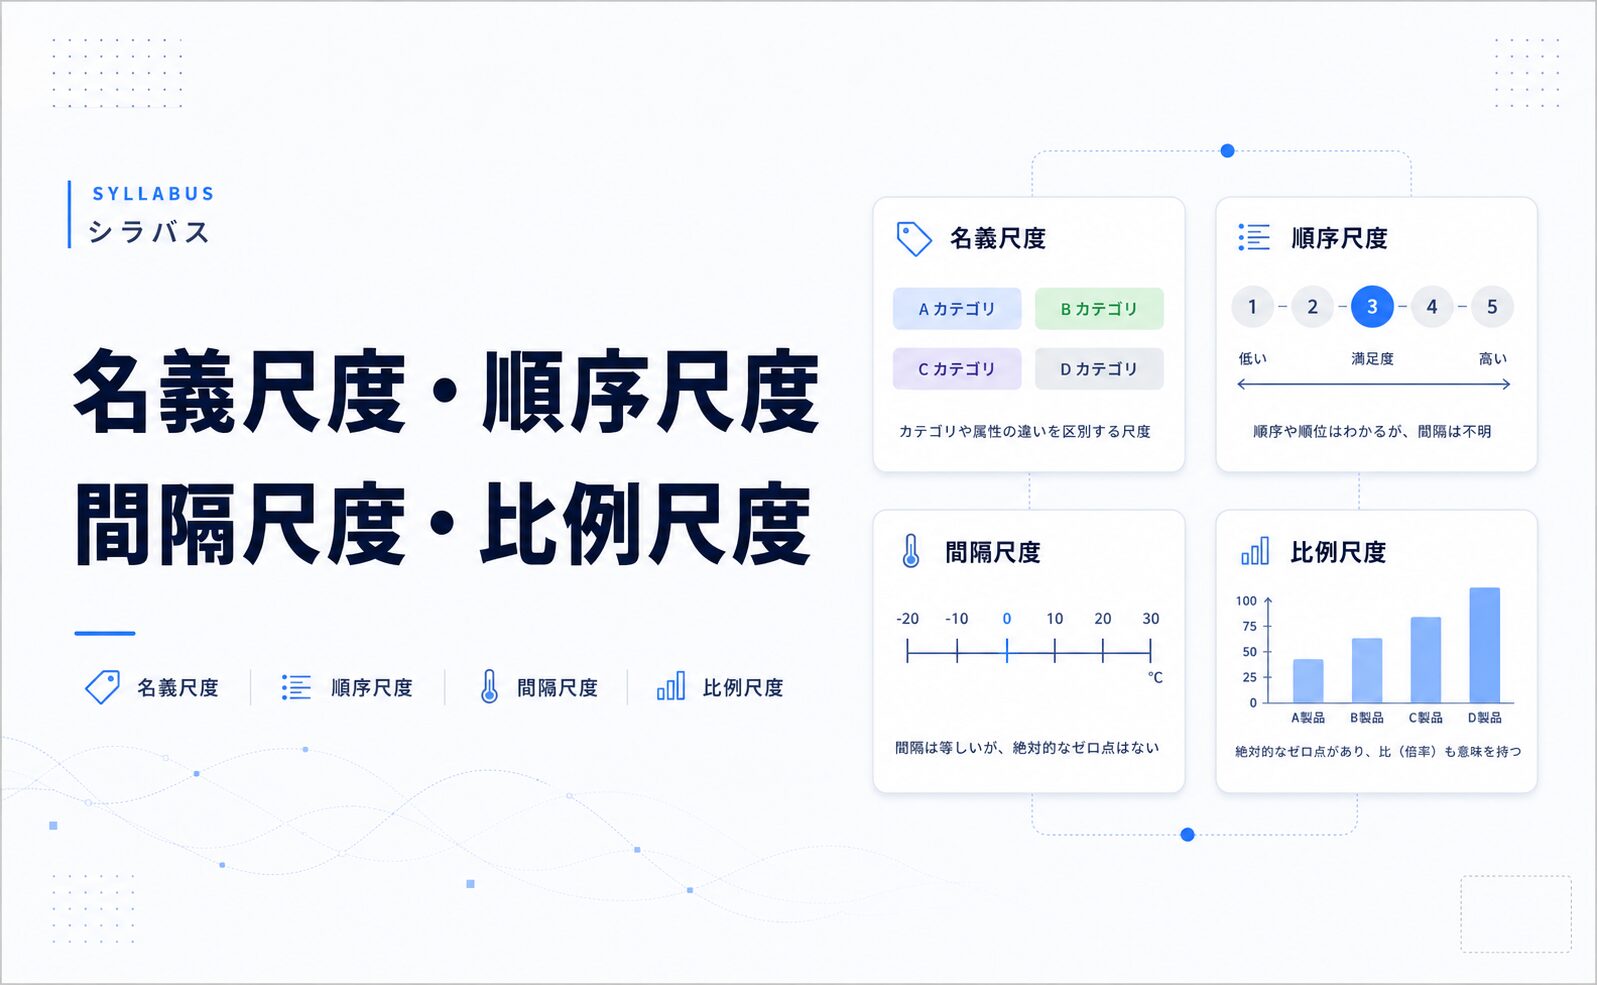
【徹底比較】順序尺度・間隔尺度・比率尺度との決定的な違い
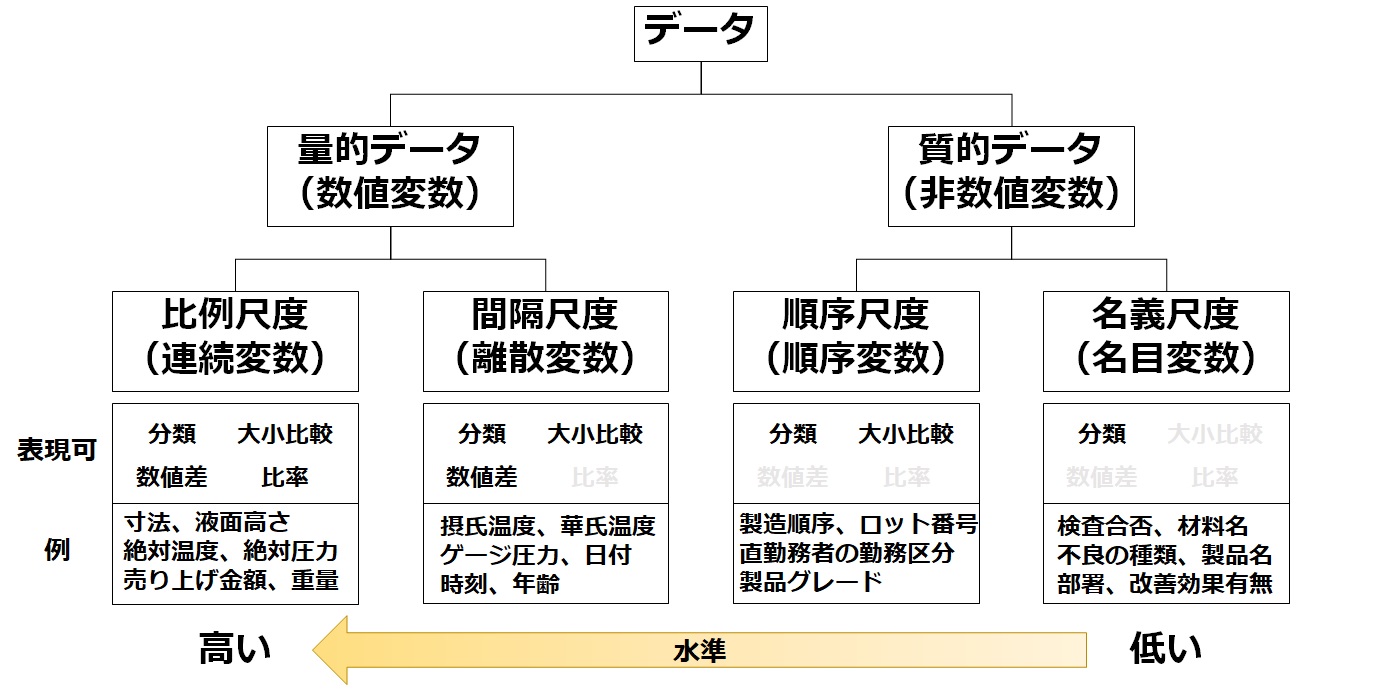
名義尺度への理解を深めるには、他の3つの尺度(順序尺度・間隔尺度・比率尺度)との比較が欠かせません。実務においてどの分析手法が適用できるかは、この尺度水準によって厳密に決まっています。
| 尺度水準 | データの性質・具体例 | 適用可能な代表値と演算 | 主な分析手法・実務上の位置づけ |
|---|---|---|---|
| 名義尺度 (質的データ) | 区別・分類のみ 例:性別、郵便番号、社員番号 | ・=、≠(等しいか否か) ・最頻値(モード) | 度数分布表、クロス集計、カイ二乗検定、ダミー変数変換 |
| 順序尺度 (質的/量的中間) | 順序・高低がある(間隔は不等) 例:満足度5段階、順位、警戒レベル | ・>、<(大小比較) ・中央値(メディアン)、最頻値 | 順位相関係数(スピアマン)、マン・ホイットニーのU検定 |
| 間隔尺度 (量的データ) | 目盛りの間隔が等しい(絶対零点なし) 例:摂氏温度(℃)、西暦年、偏差値 | ・+、−(加減の計算) ・平均値(算術平均)、標準偏差 | t検定、分散分析(ANOVA)、ピアソンの積率相関係数 |
| 比率尺度 (量的データ) | 絶対的な原点「0」が存在する 例:売上金額、体重、身長、PV数 | ・+、−、×、÷(すべての四則演算) ・すべての代表値、幾何平均 | 重回帰分析、因子分析、あらゆる高度な多変量解析・機械学習 |
名義尺度と順序尺度の見分け方
実務で頻繁に迷うのが「名義尺度と順序尺度の見分け方」です。判断基準は明快で、「データ間に自然な順番や優劣が存在するかどうか」を確認します。
たとえばアンケートで「1. 非常に満足、2. やや満足、3. 普通、4. やや不満、5. 不満」と設定した場合、数字の間隔(満足度の差)が等しいとは言えませんが、1から5に向かって満足度が下がっていく「順序関係」は明確です。したがってこれは順序尺度になります。一方で「1. Twitter、2. Instagram、3. YouTube」という利用SNSの選択肢には順序の優劣がないため、名義尺度と判定します。
一般に知られていない盲点とネットの誤解|名義尺度で平均値が計算できない理由
データ集計の現場で散見される典型的な誤謬が、「Excel等のスプレッドシートに入力されたコード番号を一括で平均してしまう」ミスです。
なぜ名義尺度の平均値を計算してはいけないのか。その理由は、割り振られた数値が量としての加加算性(足し算ができる性質)を持たないからです。
たとえば、100人の被験者(男性50人、女性50人)の属性データに対し「男性=1、女性=2」とコードを振ったとします。この数値を合計して100で割ると「平均値=1.5」が算出されます。しかし、「性別の平均が1.5」という数値には統計的な意味が一切存在しません。同様に、郵便番号「100-0001」と「900-0001」の平均を取っても、中間の地域を示すデータにはなりません。
名義尺度において有効な代表値は、もっとも出現頻度が高いカテゴリーを示す最頻値(モード:Mode)のみです。「どの選択肢を選んだ人が一番多かったのか」を集計することだけが、名義尺度の集約において数学的正当性を持ちます。
【実態検証】アンケート分析と実務現場で多用される分析手法のリアル
名義尺度は四則演算ができないからといって、分析価値が低いわけではありません。むしろ市場調査や顧客属性分析では、名義尺度こそがインサイト抽出の主役となります。
実際のビジネス現場や学術研究では、主に以下の2つのアプローチで名義尺度を料理します。
1. クロス集計とカイ二乗検定(連関の分析)
名義尺度同士の関係性を探る定番がクロス集計(Cross Tabulation)です。たとえば「性別(男性/女性)」と「購入ブランド(A社/B社/C社)」の2つの名義尺度を掛け合わせ、属性ごとの選択傾向を二次元の表にまとめます。
さらに、その集計結果に統計的な偏りがあるかどうかを検証するためにカイ二乗検定(χ²検定)を実施します。「性別によって選ぶブランドに有意な差があるか」を検定することで、単なる偶然のばらつきではなく、背後に確かな購買傾向の差が存在するかを客観的に立証できます。
2. ダミー変数化(量的分析への組み込み)
重回帰分析などの高度な多変量解析や機械学習モデルでは、数値データ(間隔尺度・比率尺度)しか直接投入できません。そこで用いられるのがダミー変数化(One-Hotエンコーディング)という分析手法です。
「血液型(A/B/O/AB)」という4分類の名義尺度を扱う場合、「A型であるか否か(1または0)」「B型であるか否か(1または0)」「O型であるか否か(1または0)」という0と1の二値データに変換します。こうして質的データをフラグ化することで、回帰モデルの独立変数として安全に組み込むことが可能になります。
統計検定やデータ分析で失敗しないための実践チェックリスト
尺度水準の選択を誤ると、どれほど精緻な計算を行ってもアウトプットは無効化されます。アンケート設計やデータ分析の初期段階で、以下の設計基準を必ず確認してください。
【プロの結論】データ分析の成否を分ける設計思想と判断基準
尺度水準の選択における最大の鉄則は、「上位の尺度(比率・間隔)は下位の尺度(順序・名義)に変換できるが、逆の変換は絶対に不可能である」という不可逆性の原則です。
- 推奨される設計(上位尺度での取得):年齢を「実年齢(数値)」で収集する。実年齢(比率尺度)で集めておけば、後から「20代、30代、40代…」という名義尺度(年代カテゴリー)へ自在に再分類できます。
- 避けるべき設計(下位尺度での固定):アンケート作成時に最初から「1. 20代、2. 30代、3. 40代」という選択肢形式(名義尺度)のみで集めてしまうと、後から「回答者の正確な平均年齢」や「詳細な年齢分布」を算出することは二度とできません。
情報量を最大化したい調査ではできる限り比率尺度や間隔尺度でデータを取得し、回答者の負担軽減やプライバシー配慮が必要な場面に限定して名義尺度を活用するという使い分けが、実務上の最適解です。

【名義尺度とは】に関するよくある質問(FAQ)
Q1:名義尺度に対してエクセルで平均値を求めてしまった場合、どう修正すればよいですか?
A1:算出した平均値は直ちに破棄してください。名義尺度の集計では「COUNTIF関数」などを用いて各項目の出現回数(度数)を数え、度数分布表を作成したうえで、最も回答数が多かった「最頻値(モード)」や各項目の構成比率(%)を算出するのが正しい集計手順です。
Q2:アンケートの「1. 賛成、2. どちらかといえば賛成、3. 反対」は名義尺度ですか?
A2:いいえ、これは「順序尺度」に該当します。選択肢の間に「賛成度の強弱」という順序関係が含まれているためです。ただし、選択肢間の心理的距離が均等であると仮定して便宜的に間隔尺度(平均値の算出など)として扱う研究例もありますが、厳密には順序尺度としての分析(中央値の算出やノンパラメトリック検定)が統計学的に正確です。
Q3:ダミー変数化するときに1つのカテゴリーを削除するのはなぜですか?
A3:統計モデルにおける「多重共線性(マルチコ)」を回避するためです。たとえば「男性」「女性」の2分類がある場合、「男性フラグ(1/0)」が分かれば女性の値は一意に確定するため、女性フラグまで同時に投入すると完全な相関が生じて計算が破綻します。そのため、カテゴリー数から1を引いた数(k-1個)のダミー変数を作成するのが鉄則です。
まとめ:尺度水準を正しく見極めて信頼性の高いデータ分析を
名義尺度は、世の中に存在するあらゆる物事を識別・分類するための基礎となるデータ形式です。一見すると単なる名前やコードの集まりに過ぎませんが、クロス集計やカイ二乗検定、ダミー変数化といった適切なアプローチを踏むことで、強力な分析結果を導き出す土台となります。
数値の見た目に惑わされず、「このデータは四則演算が可能なのか、それとも単なるラベルなのか」を意識することが、誤った集計を防ぎ、精度の高い意思決定を行うための第一歩となります。 (出典: 名義 尺度 と は(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。